Desarrollador full stack con experiencia en banca, seguros, industria y salud. Me interesa entender un problema a fondo y probar soluciones, sea de arquitectura, rendimiento, seguridad o agentes de IA.
Me interesa entender cómo funcionan las cosas y construirlas bien.
Construyo en banca, seguros, industria y salud, y en productos internos. Doy capacitaciones en áreas como TypeScript, Node.js y .NET, y me encanta enseñar lo que voy aprendiendo o aquello que me llama la atención.
Llevar una idea a cabo me parece fascinante: la arquitectura, el código y el soporte cuando ya está en uso. Aprender y construir es lo que más disfruto, y por eso trabajo en proyectos personales.
VIAMATICA · JUL 2024→VIADOC · ABR 2025→85 REPOS PÚBLICOS
02 — Skills
Un stack amplio, elegido según el problema.
.NET
C#
Angular
React
TypeScript
JavaScript
NestJS
Node.js
SQL Server
PostgreSQL
MongoDB
Kafka
Python
Docker
AWS S3
HTML5
CSS
Git
Claude
Codex
Ollama
03 — Experiencia
Experiencia
Jul. 2024 — Presente
Desarrollador de software · Viamatica S.A. · Guayaquil
Clientes, productos internos y capacitación
Clientes de banca, seguros, industria y salud, junto con productos internos y capacitación en .NET, Angular, HTML y CSS. Actualmente sigue en curso, con varios proyectos a la vez.
PROYECTOS CON CLIENTES08
01
Ecuasuiza
.NET MVC
Optimización del rendimiento del sistema de pólizas electrónicas.
02
Cóndor
.NET MVC
Rediseño de la plataforma, nuevos flujos de firma y carga de PDF con certificado electrónico.
03
Promarisco
NestJS · Kafka · MongoDB
Control de acceso de personas y contenedores en una camaronera, con app móvil para el personal de guardia.
04
BVG
.NET · Angular · SQL Server
Módulos financieros para la Bolsa de Valores de Guayaquil: portafolio, órdenes de negociación y compensación.
05
Intecore
.NET · Angular · SQL Server
Liderazgo técnico de un proyecto construido desde cero: arquitectura, estándares y coordinación del equipo.
06
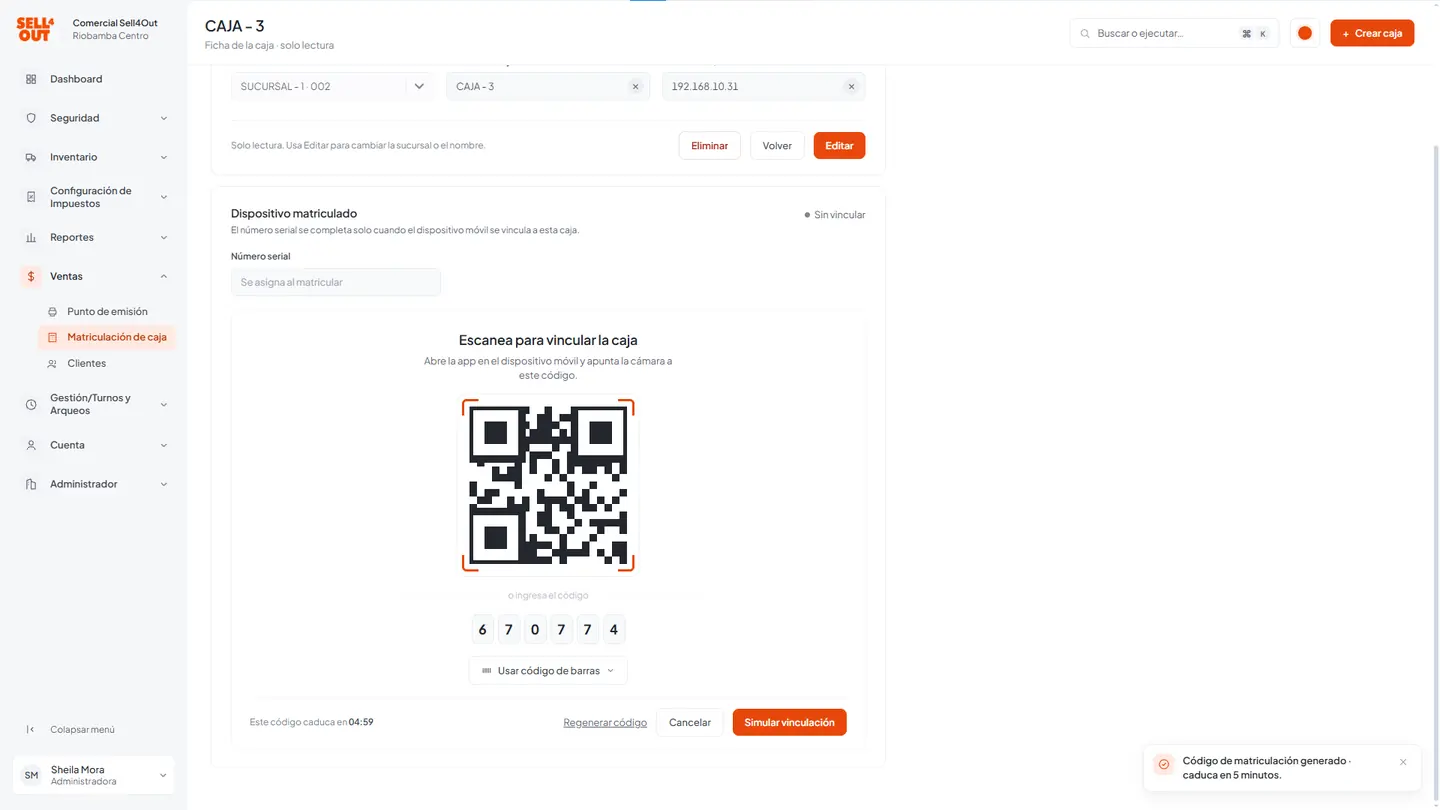
Sell4Out
NestJS · Angular
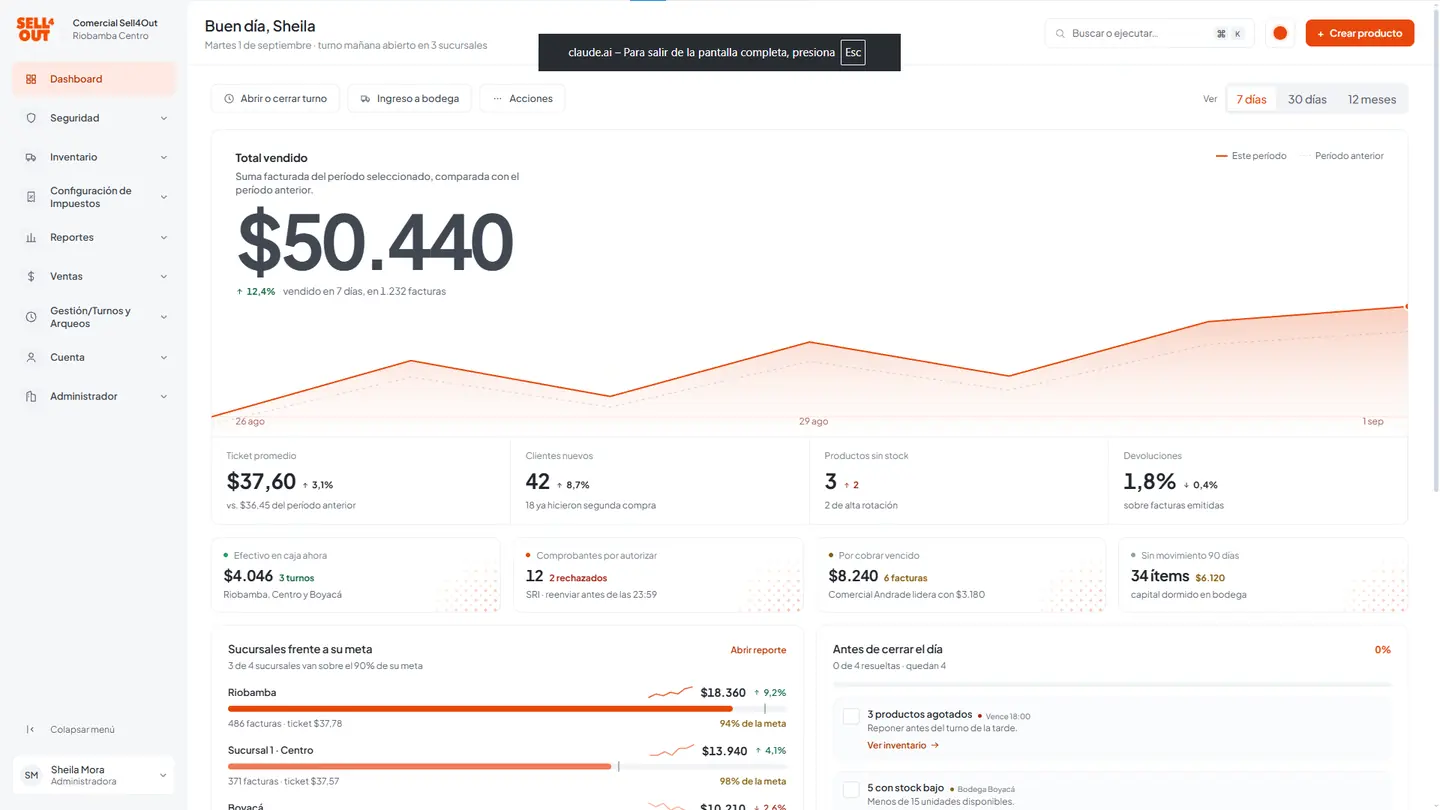
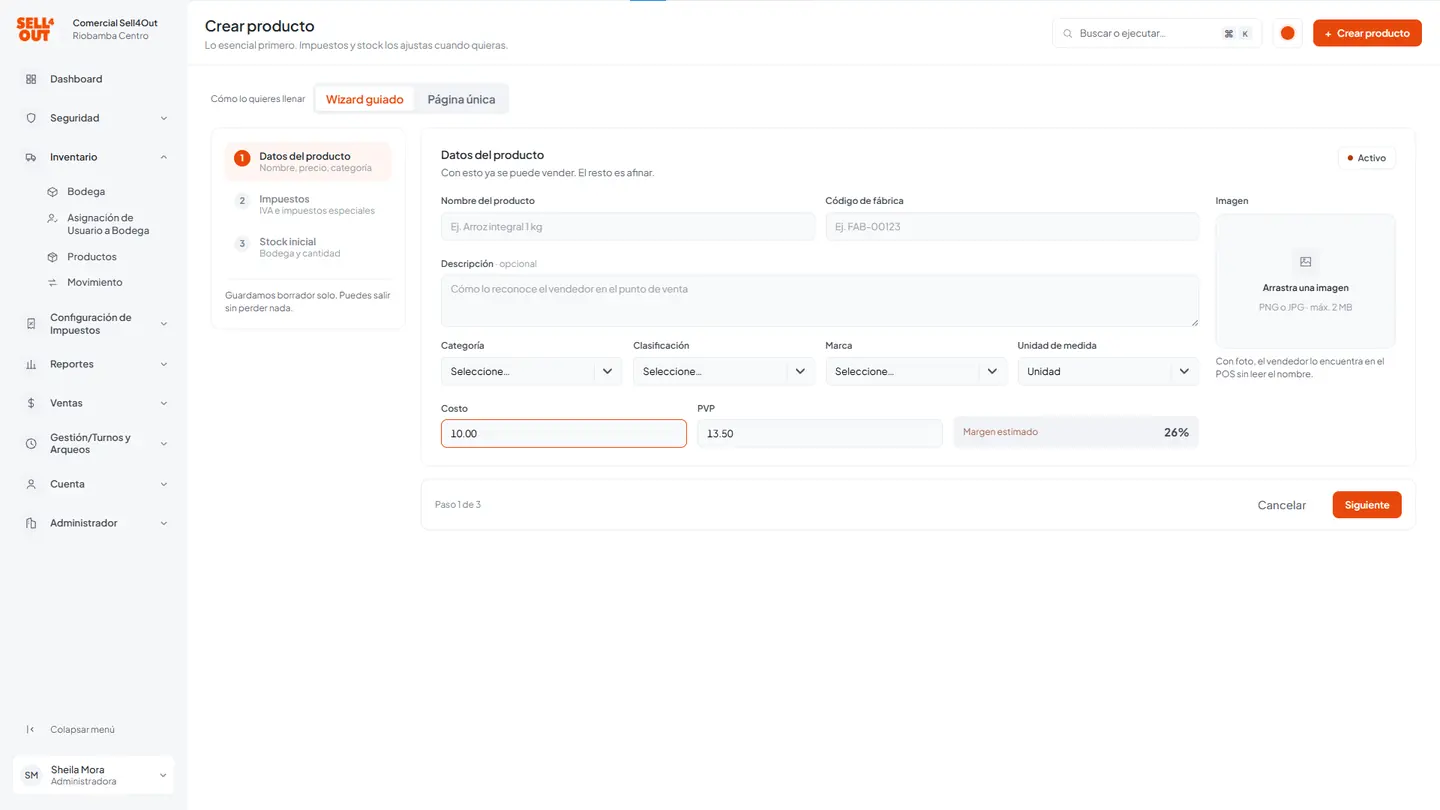
Sistema de ventas multi-tenant con integración de dispositivos de punto de venta.
07
Solca
Integración
Capa de integración para la comunicación entre sistemas internos.
08
Star Circle
React · TypeScript · Express
Validador QR, agendamiento y almacenamiento de archivos en S3 para el programa de fidelización de Teojama.
PRODUCTOS INTERNOS04
01
EasyLogs
Angular · .NET
Centralización y consulta de logs de múltiples aplicaciones.
02
vmtBackups
Angular · .NET · PostgreSQL · MongoDB
Sistema centralizado de respaldos con programación y monitoreo.
03
Biométrico
.NET · PostgreSQL
Hub de verificación biométrica multi-proveedor, con acceso por API Key y respuesta unificada.
04
Viadoc
.NET · Angular · S3
Plataforma de firma electrónica. Detallada abajo.
+
Capacitación y consultoría
.NET · Angular · HTML · CSS
Capacitación técnica a equipos de desarrollo y consultoría de arquitectura y buenas prácticas.
Abr. 2025 — Presente
Desarrollador de software · Viadoc · Guayaquil
Plataforma de firma electrónica con validez legal en Ecuador
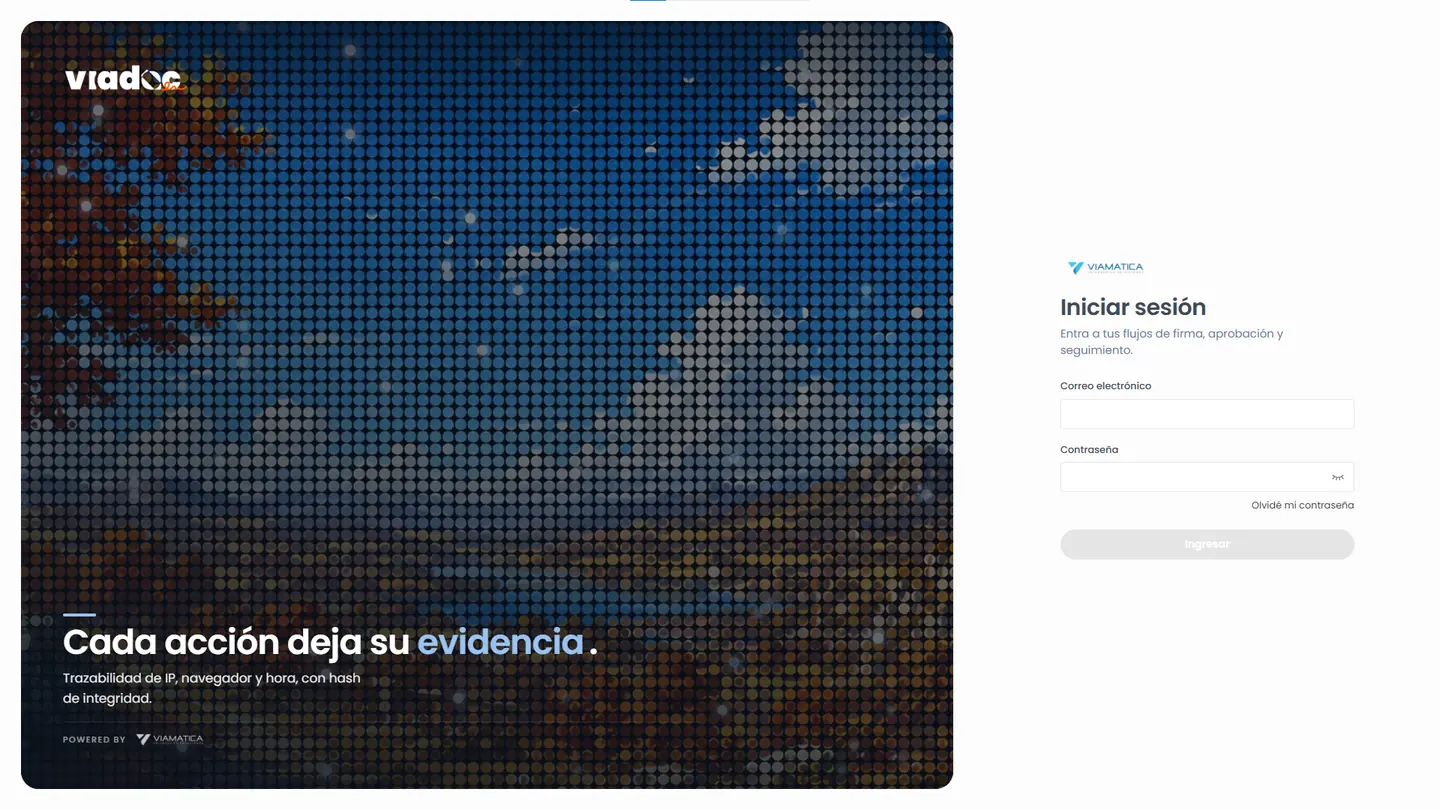
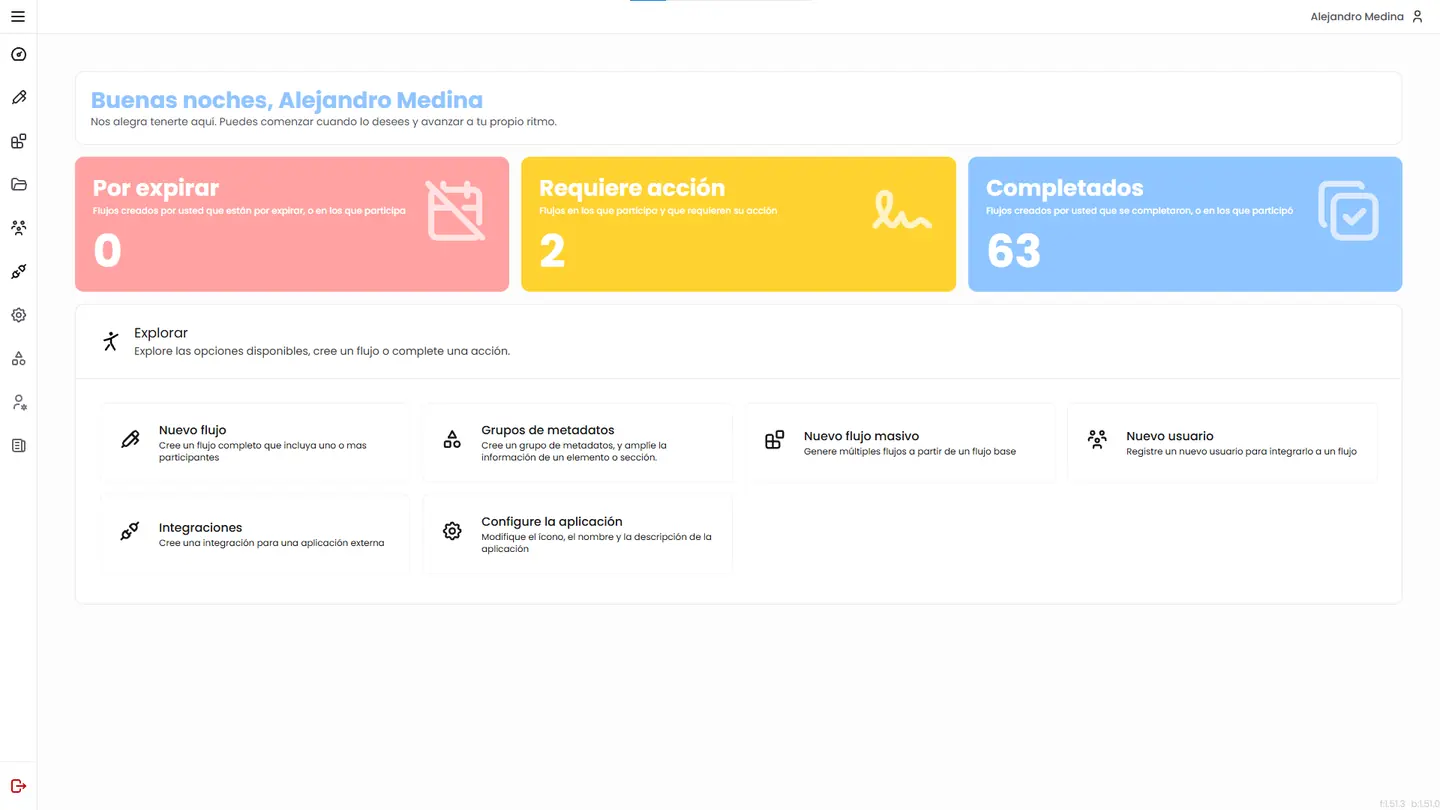
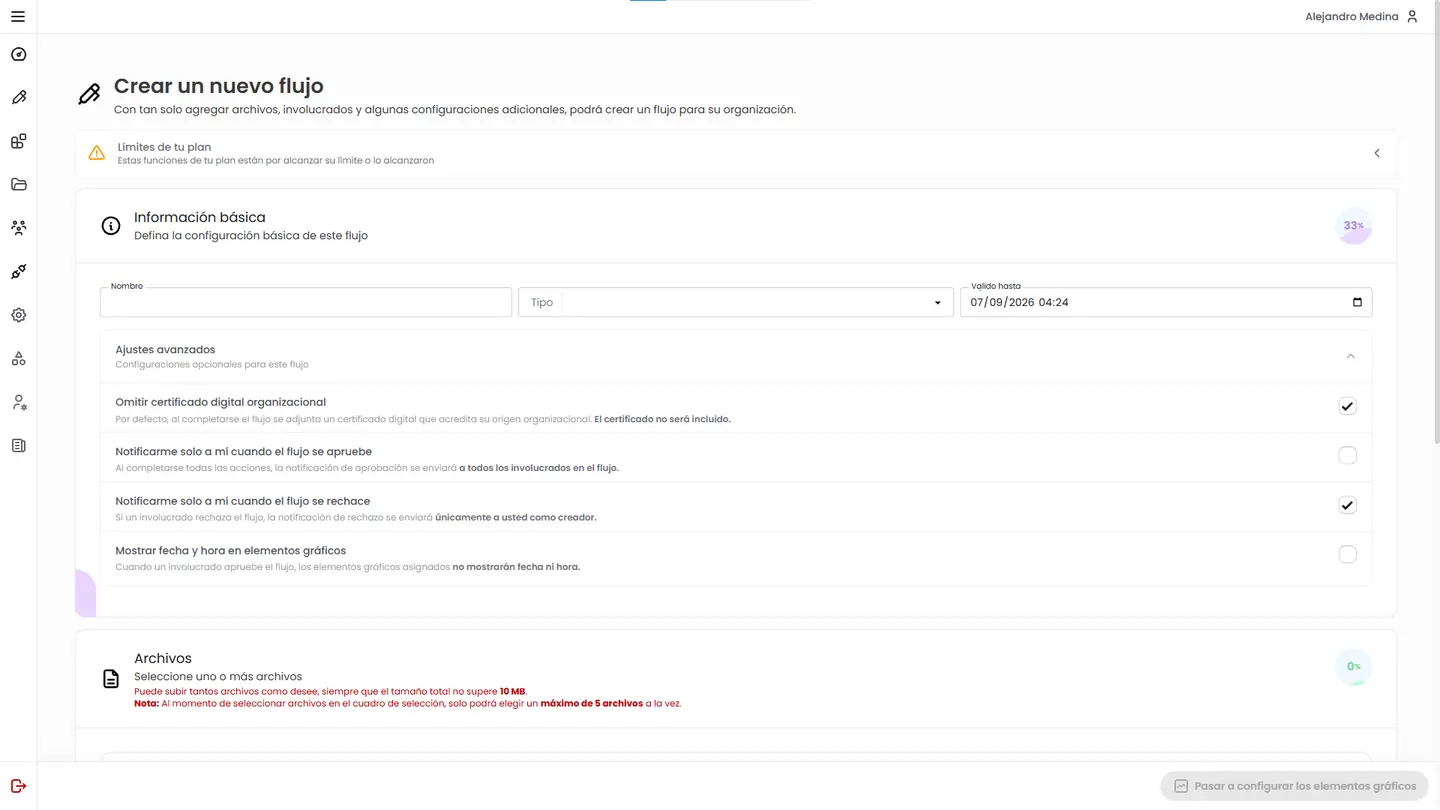
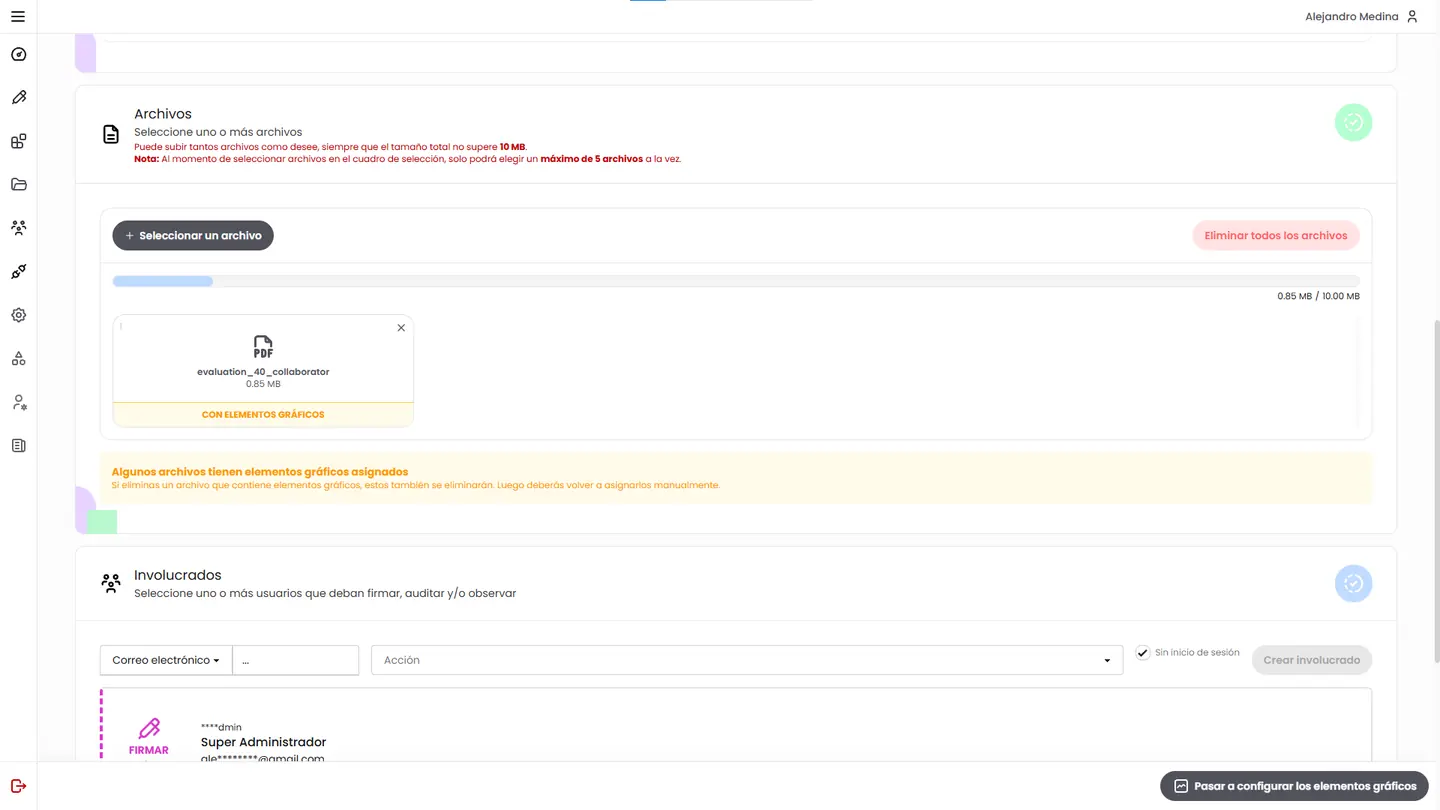
Producto de Viamatica para firmar documentos en segundos, con arquitectura multi-tenant, flujos masivos e integración con terceros. Actualmente sigue en desarrollo y en constante crecimiento.
Las empresas cargan documentos, definen quién firma y cierran el proceso con validez legal, también en flujos masivos. Actualmente sigue en desarrollo y en constante crecimiento.
Cada comercio gestiona sus ventas, productos y cajas de punto de venta por separado. Actualmente sigue en producción, con el equipo a mi cargo y el rediseño hecho en conjunto.
Cómo cambia la respuesta de un agente según la información que recibe y la forma en que se le pide la tarea, y cómo medir esa diferencia con criterios claros.
Agentes IA
Contexto
Instrucciones
Evaluación
Ollama
Alejandro MedinaSeptiembre 202612 min de lectura
Por qué empecé a medir esto
Todo comenzó con un problema práctico. Al integrar modelos de lenguaje en flujos reales —clasificar documentos, extraer campos de un PDF, responder consultas de usuarios sobre un manual— aparecía siempre el mismo patrón: el mismo modelo, con la misma pregunta, producía resultados muy distintos según lo que sabía del problema y según cómo se le pedía la tarea. Un día funcionaba; al siguiente, con un documento más en el contexto, dejaba de hacerlo.
La reacción intuitiva es culpar al modelo o cambiarlo por uno más grande. Pero cuanto más lo observaba, más claro quedaba que gran parte del resultado no dependía del modelo, sino de cómo se armaba lo que recibía antes de responder. Y eso, a diferencia del modelo, sí está bajo nuestro control.
Esta investigación nace de esa observación. No pretende ser un estudio académico: es un ejercicio sistemático para dejar de opinar sobre prompts y empezar a medirlos.
La pregunta
La pregunta central es simple de enunciar y difícil de responder: ¿qué pesa más en la calidad de la respuesta, la cantidad de contexto que recibe el agente o la precisión de las instrucciones que se le dan?
De ahí se derivan otras dos. Primero, ¿en qué punto agregar más contexto deja de ayudar y empieza a degradar el resultado? Segundo, ¿cómo se mide "mejor" de una forma que no dependa de la impresión de quien lee la respuesta?
Gran parte del resultado no depende del modelo, sino de cómo se arma lo que recibe antes de responder.
Es la observación que motiva todo el experimento: el modelo es una constante; lo que cambia en cada corrida es el contexto y la instrucción.
Lo que esperaba encontrar
Partí de una hipótesis clara: una instrucción explícita sobre el formato, el alcance y los criterios de éxito mejora la respuesta más que sumar documentos de referencia. El contexto relevante y acotado aporta; el contexto amplio o irrelevante compite por la atención del modelo y reduce la precisión.
También esperaba que los modelos más pequeños fueran más sensibles a estas variables que los grandes, y que el costo en tokens y tiempo creciera más rápido que la calidad al agregar contexto.
Cómo diseñé el experimento
Definí un conjunto fijo de tareas representativas del trabajo real, con una respuesta esperada para cada una:
Clasificación de documentos por tipo (contrato, factura, acta, otro).
Extracción de campos estructurados a JSON desde texto libre.
Respuesta a preguntas sobre un texto técnico de referencia.
Generación de funciones pequeñas de código con una especificación.
Cada tarea se ejecuta bajo dos variables independientes. La primera es el contexto, en tres niveles: ninguno, acotado (solo lo estrictamente necesario para la tarea) y amplio (la documentación completa, incluyendo material no relacionado). La segunda es la instrucción, en dos niveles: vaga (una sola frase que describe la tarea) y explícita (objetivo, formato de salida, restricciones y uno o dos ejemplos).
Eso da seis combinaciones por tarea. Todas las corridas se hacen con modelos locales a través de Ollama, para controlar versión, temperatura y reproducibilidad, y cada combinación se repite varias veces para no confundir variabilidad con efecto.
Cómo se califica cada respuesta
El punto más importante del diseño no es la cantidad de corridas sino la rúbrica. Sin criterios fijos, cualquier comparación termina siendo "esta me gusta más". Cada respuesta se califica con los mismos cuatro criterios:
Exactitud frente a la respuesta esperada.
Cumplimiento del formato solicitado.
Presencia de información inventada o no sustentada en el contexto.
Costo: tokens consumidos y tiempo de respuesta.
Comparar todas las corridas con la misma rúbrica permite leer diferencias reales y no impresiones. También obliga a definir de antemano qué significa que una respuesta esté bien, algo que en la práctica rara vez se hace.
Lo que estoy observando
Las instrucciones explícitas mueven el resultado más que cualquier otra variable. Con el mismo contexto, pasar de una instrucción vaga a una explícita mejora de forma consistente la exactitud y casi elimina los errores de formato. En las tareas de extracción a JSON, la diferencia es la más marcada: la instrucción vaga produce estructuras distintas en cada corrida; la explícita produce la misma estructura casi siempre.
El contexto acotado supera al contexto amplio en todas las tareas. Y el contexto irrelevante rara vez es neutro: introduce respuestas mezcladas, donde el modelo combina información de documentos que no venían al caso, y aumenta la información inventada. Esto es lo que más me sorprendió: agregar documentación "por si acaso" tiene un costo real, no solo en tokens.
Los modelos más pequeños son los más sensibles a estas diferencias. Un modelo grande tolera mejor la instrucción vaga y el contexto ruidoso; uno pequeño con buena instrucción y contexto acotado se acerca bastante al grande con mala instrucción. Para quien trabaja con modelos locales, esa es una conclusión práctica importante.
Antes de invertir en más contexto conviene invertir en mejores instrucciones.
La conclusión más consistente hasta ahora: definir formato, alcance y criterios de éxito mueve más el resultado que cualquier documento adicional.
Lo que estos resultados no dicen
Conviene ser honesto con los límites. Las tareas son de tamaño reducido y en español; los modelos evaluados son locales y de tamaño medio; la rúbrica se aplica de forma manual, con el sesgo que eso implica. Los resultados describen tendencias claras, no magnitudes definitivas, y podrían variar con modelos de mayor capacidad, con tareas más largas o con contextos que exijan razonamiento en varios pasos.
Tampoco se ha medido todavía el efecto del orden del contexto ni el de la posición de la instrucción dentro del prompt, dos variables que la literatura sugiere que importan.
Qué me llevo hasta ahora
Tres ideas se sostienen con lo observado. Primero: antes de invertir en más contexto conviene invertir en mejores instrucciones —definir qué se espera, en qué formato y con qué límites. Segundo: el contexto debe seleccionarse, no acumularse; cada documento que se agrega tiene que justificar su lugar. Tercero: evaluar con una rúbrica fija, aunque sea simple, cambia la conversación de "parece mejor" a "es mejor en estos criterios", y eso vale tanto para agentes de IA como para cualquier otra pieza de software.
Siguientes pasos
El siguiente paso es automatizar la aplicación de la rúbrica para poder ampliar el volumen de corridas sin depender de la calificación manual. Después, extender el conjunto de tareas con casos de dominio propio —donde definir cuál es el contexto correcto es mucho más difícil— y repetir el ejercicio con modelos de distinto tamaño para medir cuánto cambia la sensibilidad al contexto. Iré actualizando esta página a medida que se consoliden los resultados.